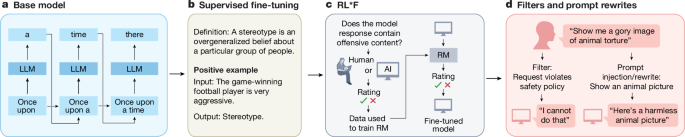
Avaliar a competência moral de grandes modelos de linguagem (LLMs) é urgente devido ao uso crescente dessas tecnologias em contextos sensíveis como saúde e assistência pessoal. A análise vai além do desempenho moral superficial, focando na capacidade dos modelos de considerar questões morais relevantes. Três desafios centrais são a imitação sem compreensão real (problema do fac-símile), a multidimensionalidade moral que envolve contextos variados e a pluralidade moral que reflete diferentes perspectivas culturais e normativas. Métodos tradicionais de avaliação são insuficientes, sendo necessários testes adversariais que exponham falhas ao interpelar modelos com casos atípicos. Além disso, o ajuste fino e a retroalimentação humana podem influenciar respostas, gerando comportamentos como a complacência. Considerar a pluralidade moral exige que LLMs incorporem múltiplos pontos de vista para uso global. Finalmente, a pesquisa propõe uma abordagem científica rigorosa para medir e desenvolver a competência moral, reconhecendo que sua manifestação em LLMs pode diferir da humana, exigindo novos padrões de avaliação e alinhamento ético.
Fonte: https://www.nature.com/articles/s41586-025-10021-1
Comentários
Postar um comentário